Datenpipelines und Sync
Geplante und ereignisgesteuerte Pipelines aus Shop, Warenwirtschaft, Marketing und weiteren Systemen – inkrementell, wo es geht, mit Wiederholungen, Blättern innerhalb der Grenzen jeder API und Nachladen der Historie.
 / Data Engineering
Wir bauen die Pipelines und das Datenmodell, die Daten aus Shop, Warenwirtschaft und Marketing zusammenführen: nach Zeitplan synchronisiert, gegen die Quellsysteme abgeglichen und bereit für Dashboards, Prognosen und AI. Eine solche Plattform betreiben wir selbst – auf PostgreSQL, mit stündlichem Katalog-Sync und einer vereinten Bestellhistorie aus Shopify und plentymarkets.
Alle Quellen in einem Modell
BeispielQuellen
Ein Modell, eine verlässliche Quelle
orders_unified
Sync stündlich
Bestellungen pro Woche · alle Kanäle
Kommt dir bekannt vor?
Die Daten sind da – verteilt auf Shop, Warenwirtschaft, Marketing-Tools und ein paar Tabellen. Was fehlt, ist ein Ort, an dem sie zusammenpassen.
Der Shop meldet einen Umsatz, die Warenwirtschaft einen anderen, das Marketing-Tool einen dritten. Jede Besprechung beginnt mit der Frage, wessen Zahl stimmt.
Jemand exportiert CSV-Dateien und führt sie in einer Tabelle zusammen. Der Bericht ist veraltet, wenn er fertig ist, und niemand sonst kann ihn nachbauen.
Viele Schnittstellen liefern nur den aktuellen Stand oder ein begrenztes Zeitfenster. Ohne eigene Ablage lässt sich das Bild vom letzten Jahr nicht wiederherstellen.
Prognosen und AI brauchen saubere, verknüpfte, historische Daten. Ohne diese Grundlage rät jedes Modell.
Was wir bauen
Wir bauen die Schicht zwischen deinen operativen Systemen und allem, was daraus lesen will. Sechs Bereiche, in denen wir arbeiten:
Geplante und ereignisgesteuerte Pipelines aus Shop, Warenwirtschaft, Marketing und weiteren Systemen – inkrementell, wo es geht, mit Wiederholungen, Blättern innerhalb der Grenzen jeder API und Nachladen der Historie.
Ein relationales Modell auf PostgreSQL, in dem Bestellungen, Produkte, Kunden und Bestände aus verschiedenen Systemen dasselbe bedeuten. Dokumentiert, mit Schlüsseln, die über die Quellen hinweg passen.
Eine Bestellhistorie und ein Produktkatalog über Shops und Warenwirtschaft hinweg, mit Verkaufszahlen je Produkt – so, wie wir es für die Shops führen, die wir betreiben.
Anzahlen und Summen gegen die Quellsysteme geprüft, Dubletten und Lücken erkannt, Abweichungen gemeldet statt still mitgeschleppt.
Dashboards und geplante Berichte auf dem Modell: Umsatz, Bestand, Kunden, Marketing – mit denselben Definitionen in jeder Ansicht.
Aufbereitete, historische Datenbestände, mit denen Prognosemodelle und AI Agents arbeiten können – inklusive Regeln, wer und was welche Daten lesen darf.
So läuft es ab
Wir stimmen das Modell ab, bevor wir Pipelines bauen, und binden eine Quelle nach der anderen an. Jede Ladung wird gegen das System geprüft, aus dem sie kommt.
Wir listen die Systeme, ihre Schnittstellen und Grenzen und die Fragen, die die Daten beantworten sollen. Du bekommst einen schriftlichen Plan: Quellen, Zielmodell, Reihenfolge.
Objekte, Schlüssel und Definitionen – was als Bestellung, als Umsatz, als Kunde zählt – schriftlich abgestimmt, bevor die erste Pipeline entsteht.
Die Pipelines entstehen Quelle für Quelle, die Historie wird nachgeladen und jede Ladung gegen das Quellsystem abgeglichen.
Die ersten Dashboards und Berichte auf dem neuen Modell, dazu der Zugriff für deine Tools und dein Team.
Monitoring mit Warnungen bei fehlgeschlagenen oder verspäteten Ladungen, geplante Abgleiche und neue Quellen, wenn du sie brauchst. Oder die Übergabe an dein Team.
Belege
Shops, die wir betreiben. Ihr Tagesgeschäft läuft auf der Plattform, die wir für unseren eigenen Betrieb gebaut haben – Produktion, kein Demo-Setup.
Migration · Langfristige Partnerschaft
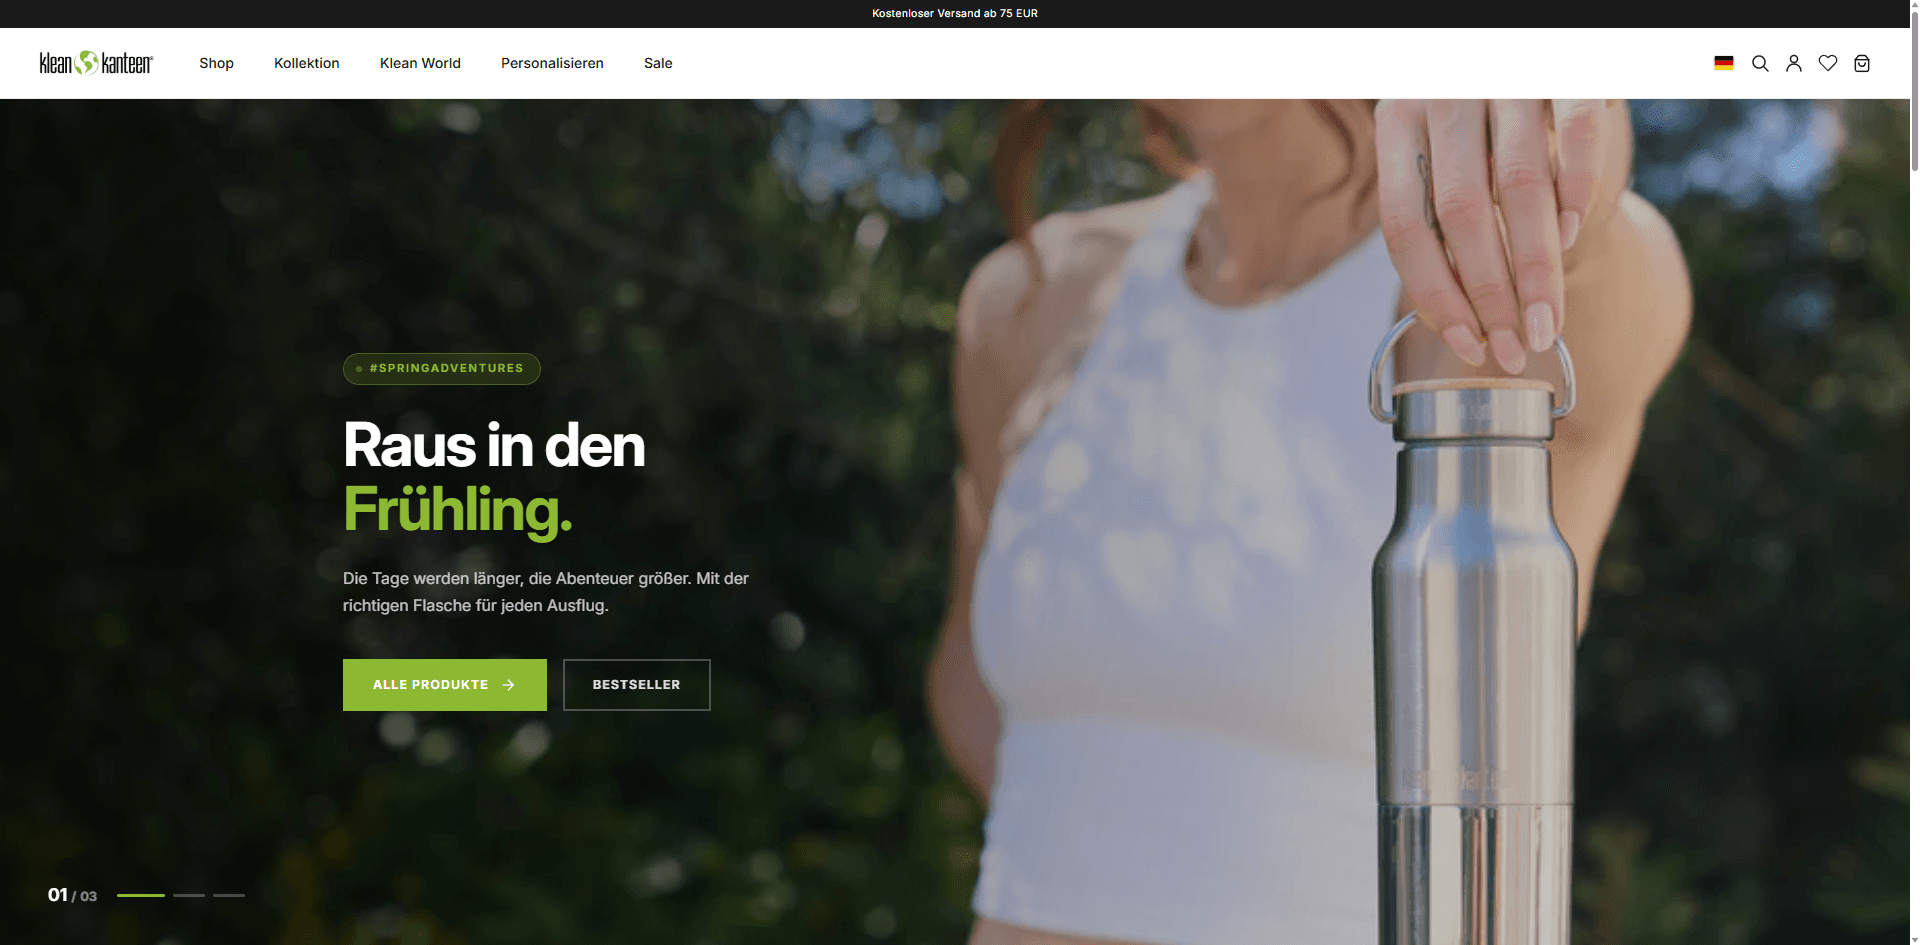
Klean Kanteen Deutschland, seit 2017 betreut: Shopify-Shop mit Anbindung an Warenwirtschaft und Fulfillment-Partner, Katalog, Bestellungen und Kampagnen im Tagesbetrieb.
Migration
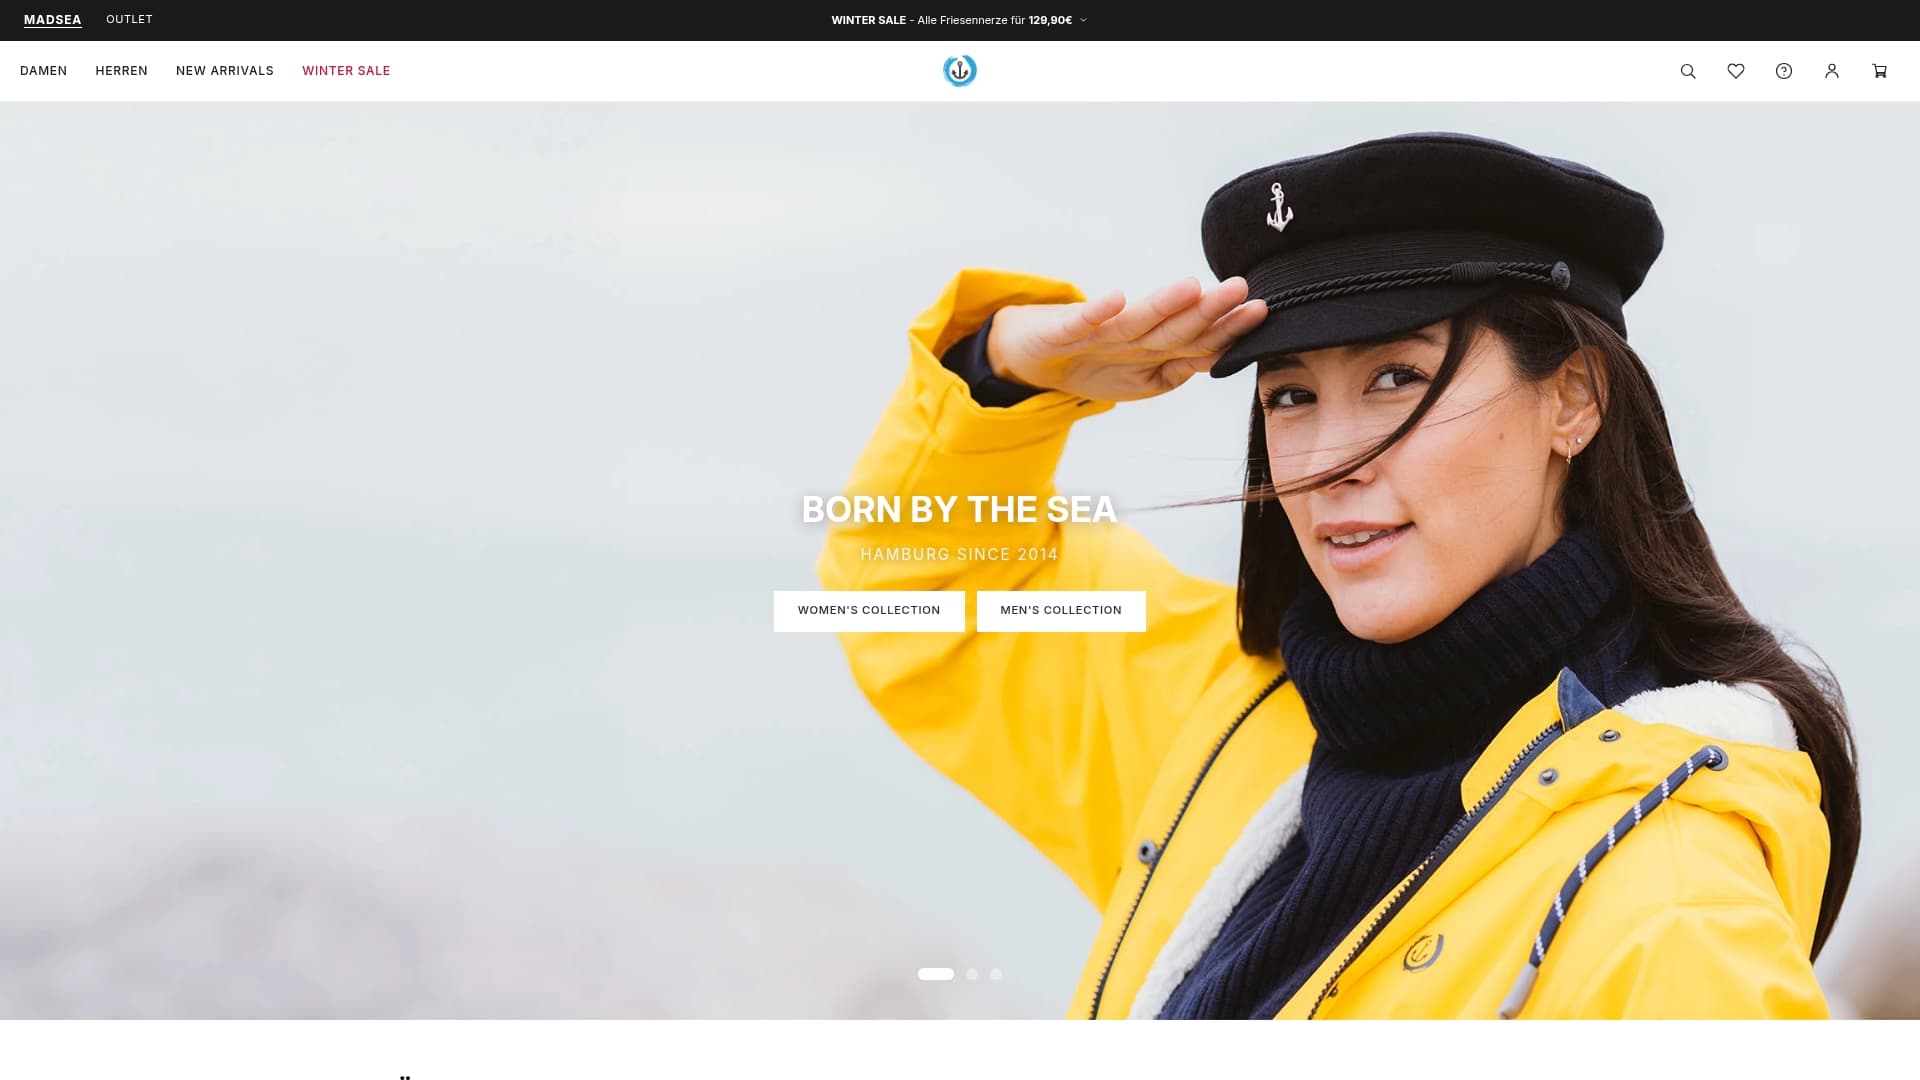
MADSea: Shopify-Shop, den wir operativ betreiben – Katalog- und Bestell-Sync in unsere Operations-Plattform, Treueprogramm aus Bestelldaten berechnet, Events an Klaviyo weitergegeben.
Zusammenarbeit
Eine Datenplattform nützt, wenn man ihren Zahlen traut. Deshalb wird jede Pipeline gegen ihre Quelle abgeglichen, bevor jemand einen Bericht darauf baut. Umfang und Preis stehen schriftlich fest, bevor wir bauen.
Zum Einstieg
Quellen, Schnittstellen, Definitionen und das Zielmodell – aufgeschrieben, bevor etwas gebaut wird.
Das Fundament
Datenbank, Pipelines, Nachladen der Historie und die ersten Dashboards, Quelle für Quelle angebunden.
Dauerhaft am Laufen
Wir betreiben die Pipelines, reagieren, wenn sich eine Schnittstelle ändert, und ergänzen Quellen, Berichte und Datenbestände nach Bedarf.
FAQ
Sag es uns. Wir melden uns mit einem Termin fürs Erstgespräch und einer ersten Einschätzung, welche Quellen und welches Modell es dafür braucht – unverbindlich.